有了服务需求,
应用商店就能接住吗?
同样是找 App,已经知道目标应用,和只有一个大概需求,走的是两条不同的路。
| 用户状态 | 会怎样表达 | 应用商店能否满足 |
|---|---|---|
| 意图清晰 有明确的目标应用 | 已经知道搜什么、怎么搜。 例如:全球上网、Grab、CapCut。 | 关键词匹配目标应用,直接下载。 |
| 意图模糊 只有大概方向,不知道该用哪个 App | 用自然语言描述目标、场景、限制和偏好。 例如:泰国旅行必备 App;字大又简单的视频通话软件。 | 可能返回了一些应用,但没有很好地回答“哪个适合我、为什么”。用户继续去 UGC 平台找经验。 |
意图清晰:搜到就能下载
意图模糊:商店没接好,继续去别处找
用户要的可能是“出国旅游怎么准备”,商店给的却只是“搜到的应用”。表达、比较和安装后怎么用,仍然要靠用户自己完成。
不知道该搜什么词
多条件、口语化表达和隐性偏好,需要用户自己压缩成关键词。
找到,不等于决定
一堆相似应用之外,还缺“哪个更适合我、为什么”的建议。
安装,不等于能用
应用怎么用、有什么内容和活动、如何完成任务,需求还会继续。
展开完整用户旅程图
过去没有充分承接,
现在为什么又要做?
能力有边界,也认为没有那么必要。
用户已经有别的去处
UGC 平台和搜索引擎承接自然语言问题,也提供个人体验、评价和使用情境。
商店缺少相应能力
自然语言理解、真实体验内容、场景理解和延伸服务,都需要进一步建设。
当时的判断“不论用户在哪搜,最后都要回到商店下载。”
入口在变化,能力也具备了。
我们重新考虑了两件事:分发入口的变化,以及应用商店能否重新成为用户愿意探索的地方。
有必要做
- UGC 平台逐步具备分发能力,商店的入口价值面临变化。
- 用户在商店“探索”的欲望降低,我们希望从纯下载工具延伸到应用、内容和服务。
有能力做
- 大模型提供自然语言理解、表达和场景理解能力。
- 用户体验反馈、应用内容和服务供给,可以逐步建设。
做出来,用户看到的是什么?
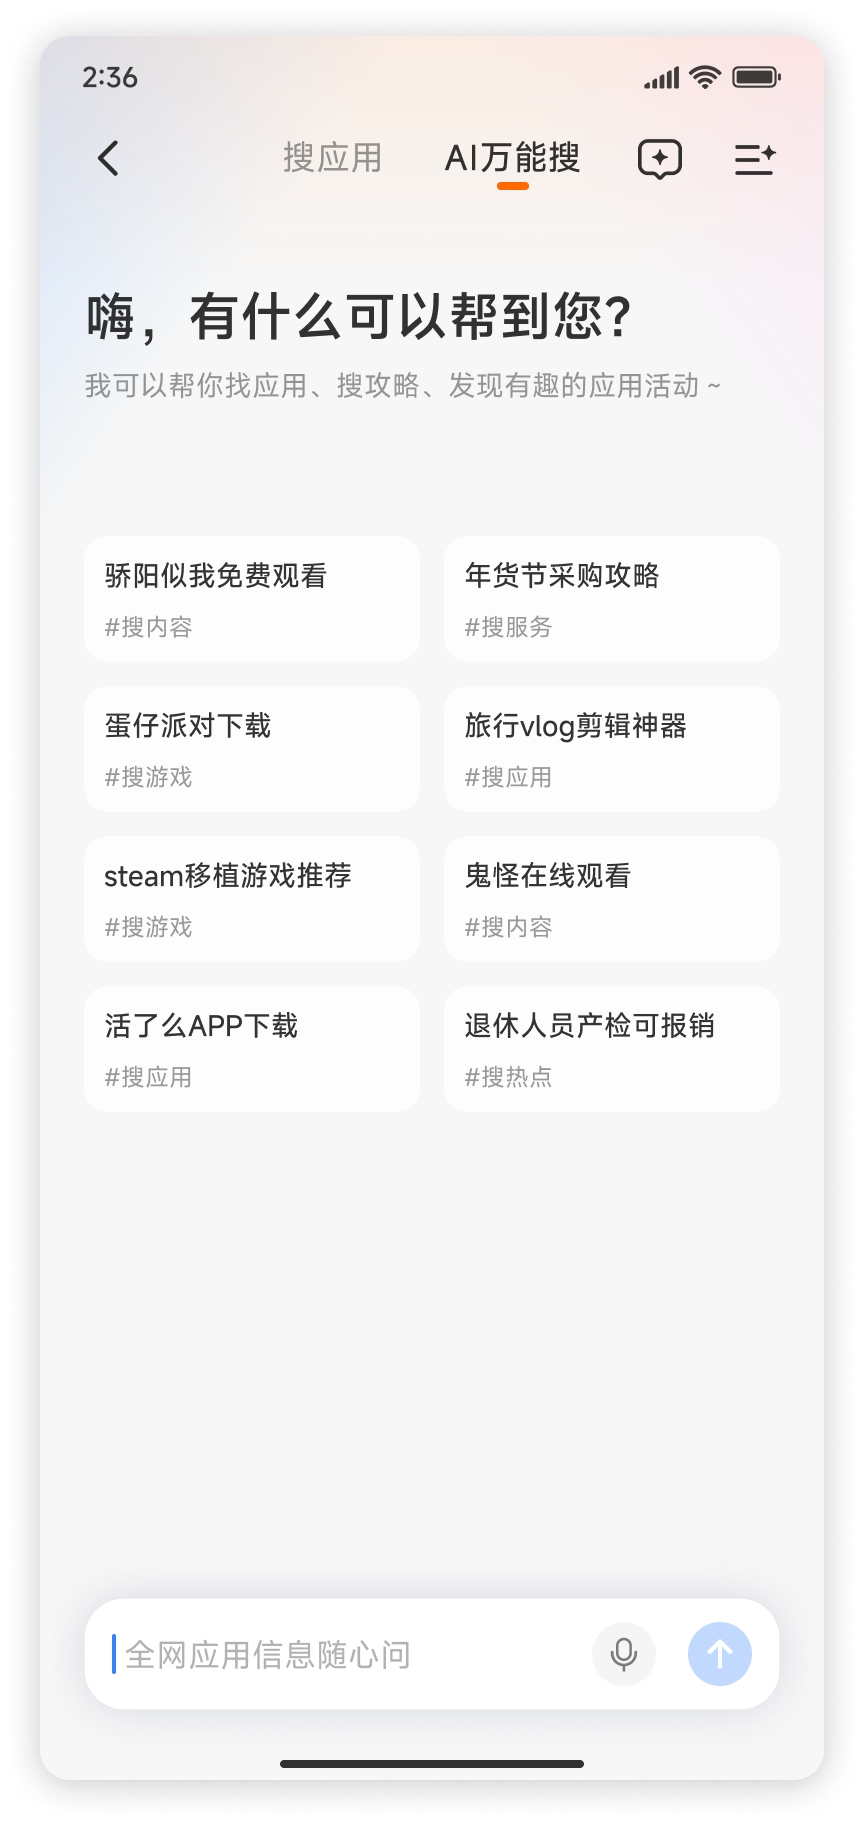
先把完整体验放在一起看:从搜索入口进入,得到回答、继续追问、核对引用,再到找回历史对话。
接下来,沿着这条体验拆开看:用户只说一句话,我们在背后要完成多少事?
第一步,先让用户敢说、会说。
先分清明确需求和模糊/复杂需求,再决定入口和引导怎么做。
明确需求:保障效率
用户已经知道要找哪个 App,优先保证快速找到、直接下载,保留熟悉的搜索路径。
模糊/复杂需求:鼓励表达
用户只有大概方向,或带着多种条件,需要一个独立空间来描述场景、说清需求。
一个大模型,能把所有事都做好吗?
成熟的方案不是纯大模型回答,而是把问题拆成“鉴权与风控 → 意图分流 → 改写与检索 → 供给与核验 → 组织回答”的模型与工程配合链路。
模型负责理解和组织表达,工程负责检索、供给校验、排序与运营能力。
先判断能不能回答
用户问题先经过鉴权与风控。不是所有输入都应该直接进入生成环节。
不同任务,不同路径
明确找 App、比较 App、解决问题、找内容、找服务。
理解与表达
理解口语、归纳需求、生成追问、组织回答。
真实可用的供给
类目、标签、评分、版本、机型适配、地区可用性、下载状态。
模型与工程如何配合
用户说“搜”,
背后可能是完全不同的任务。
将用户 Query 直接喂给大模型,能得到均分 60 分的回答;
依据不同意图,将 Query 喂给不同调教取向的大模型,能得到 80+ 分的回答。
“WhatsApp”
用户要的是应用卡片或直接下载,不是等一分钟,再读一千字的介绍。
对应能力:应用直搜 Agent
“适合英语不太好的人去泰国用的离线导航”
按照复杂条件筛选应用,解释推荐原因,并给出决策建议。
对应能力:模糊需求搜 App Agent
“这个游戏新手怎么快速升级”
用户需要攻略、玩法、活动内容。
对应能力:应用服务 / 内容搜索 Agent
“Spotify 有什么适合通勤听的歌单”
用户想找 App 内的内容或服务。
对应能力:应用服务 / 内容搜索 Agent
用户的一句话,
为什么不能直接拿去检索?
讲解示例我下周去泰国旅行,想找一个能离线导航、少费流量、适合英语不太好的人的 App。
人听起来清楚的一句话,放进检索系统里仍有歧义。“离线导航”是离线地图,还是离线路线规划和语音导航?“英语不太好”又该转成什么可验证的信号?
| 用户原话 | 系统需要弄清楚的事 |
|---|---|
| 去泰国旅行 | 地图覆盖、地区可用性,还是旅游内容? |
| 离线导航 | 离线地图、离线路线规划、离线语音导航,能力边界不同。 |
| 少费流量 | 可能没有现成结构化字段,需要找可核验的信息。 |
| 英语不太好 | 转成语言支持、视觉引导、易用性等候选信号。 |
| 下周 | 对 App 推荐本身影响有限,但意味着用户要提前准备,且应用在当前设备上可用。 |
给内容库
扩大召回
把原话转成多种检索表达、类目和语义任务,减少对原始措辞的依赖。
给过滤与排序
分清条件
硬条件用于筛选;偏好用于排序和解释。离线能力的边界,需要真实资料确认。
给联网检索
围绕不确定事实找证据
围绕候选应用核验离线能力、使用方式和语言支持。内容库质量不足时,也可以先联网,再匹配应用库。
Query 改写要实现「消歧、拆解、补全、过滤」。
Query 改写示例
以下代码为 AI 讲解示例,非真实实现。
给内容库
扩大召回,不只依赖用户原话。
{
  "search_queries": [
    "Thailand offline map",
    "Thailand offline navigation",
    "offline travel navigation"
  ],
  "categories": [
    "Maps & Navigation",
    "Travel"
  ],
  "semantic_query": "适合泰国旅行、支持提前下载地图或离线导航、尽量节省流量、对英语能力有限用户友好的地图应用"
}
给供给过滤与排序系统
离线能力、泰国覆盖、可下载、设备兼容
= 硬条件,必须由工程和真实数据过滤
少流量、低语言门槛、易用
= 偏好,适合用于排序与解释
{
  "hard_filters": {
    "supports_offline_map_or_navigation": true,
    "thailand_coverage": true,
    "available_in_user_store_region": true,
    "compatible_with_current_device": true
  },
  "ranking_preferences": [
    "low_data_usage",
    "chinese_or_localized_ui",
    "clear_visual_guidance",
    "easy_to_use",
    "recently_maintained"
  ]
}
给联网检索
不是再搜一遍“泰国地图 App”,而是围绕候选 App 的不确定事实去拓展&核验。
对内容库质量要求极高,所以也有先联网搜索,再匹配应用库的逆向做法。
{
  "web_search_queries": [
    "official offline maps Thailand [candidate app]",
    "official help download offline map Thailand [candidate app]",
    "official language support [candidate app]"
  ],
  "goal": "补充或核验自有库中不完整的离线能力边界、使用方式与时效信息"
}注入上下文,把用户原话转成内容库检索和联网检索可执行的任务计划。
商店资料不够时,
去哪里补,哪些内容不能信?
下载状态、设备兼容,查商店/系统自有数据;应用能力、时效内容和使用经验,用外部信息补齐。
| 要确认的信息 | 信息来源 | 为什么 |
|---|---|---|
| 当前商店能否下载 | 商店/系统自有数据 | 商店供给才是对应的权威事实。 |
| 兼容当前设备吗 | 商店/系统自有数据 | 网页无法确认用户的设备状态。 |
| 具体离线功能边界 | 外部信息 | 优先查官方资料;商店描述可能过短或过旧。 |
| 当地交通、天气、旅行规定 | 外部信息 | 信息变化快,需要及时更新。 |
| 版本攻略、限时活动 | 外部信息 | 优先查官方内容;版本和活动时效强。 |
| 用户评价、使用经验 | 外部信息 | 筛选真实使用内容,注意噪音、偏差与 SEO。 |
- 01召回与过滤候选
- 02找出影响决策的不确定事实
- 03定向联网核验
- 04将证据与候选绑定
- 05组织回答
踩过的坑:搜得到,不代表内容值得消费。
我们发现,联网检索拿到的内容“可消费”的价值不够高,还需要补足真实体验和内容丰富度。
迅速接入微博 Agent,
以流量换内容。
把微博内容带进搜索回答,再通过引用来源连接原始博文。
查看原文保留的其他搜索与内容截图
有了资料,
还要把回答做得有用、可信。
你理解我了吗?
简洁说明对需求的理解和推荐方向。
接下来怎么做?
应用卡片、内容或服务入口。
凭什么推荐?
满足哪些条件,可能有什么限制。
Prompt 如何约束回答:五条设定准则
| 准则 | 解决的问题 | 对本案例意味着什么 |
|---|---|---|
| 先理解任务,不是匹配词 | 避免只返回热门地图 App。 | “泰国 + 导航”之外,还要识别离线、省流量和低语言门槛。 |
| 硬条件优先于偏好 | 避免“高分但不满足需求”的错误。 | 离线可用是硬条件;中文/易用、省流量是排序偏好。 |
| 只在必要时追问 | 降低对话成本与流失。 | 本例信息已经足够,不该再多问一轮。 |
| 只基于可核验事实 | 控制幻觉,保证可信。 | 不得自行断言 App 支持泰国离线导航或中文。 |
| 回答要支持决策 | 从“搜索列表”升级为“完成任务”。 | 给出首选/备选、适用边界和出发前操作。 |
示例 Prompt:角色、目标与五条回答规则
你是应用商店的 AI 搜索专家。

你的目标是理解用户的真实任务,
从真实、可验证的应用商店供给中,
推荐最适合用户的 App,并帮助用户完成下载决策。

工作规则:
1. 先理解需求,再检索
识别用户的核心任务、使用场景、硬性条件、偏好与隐含限制,
不要只按用户原话做关键词匹配。

2. 区分“必须满足”和“更优选择”
必须满足的条件用于过滤;
偏好和体验要求用于排序。

3. 只在必要时追问
仅当缺失信息会明显改变推荐结果时追问;
每次只问一个最关键的问题。
若用户未回答,基于合理假设继续给出可用结果。

4. 只基于已验证事实推荐
不得编造 App 的功能、价格、地区可用性、兼容性或评价。
信息不完整时,明确说明不确定性。

5. 输出帮助用户决策
默认推荐不超过 3 个 App。
每个 App 必须说明:
- 为什么适合用户;
- 满足了哪些关键需求;
- 有哪些使用限制或注意事项。
最后给出不同偏好下的选择建议和下一步行动。
交互案例
让内容和下一步动作接上
回答可以组织用户所需的内容,同时给出对应的应用入口。
有时拼命调 Prompt,
是在错误的方向使劲。
模型与 Prompt 上,我们踩过两个坑:底层模型的能力会影响上限,沿用的规则也可能反过来拖累新模型。
第一件事:别低估模型本身的影响。
前期使用较便宜的模型,把大量精力放在调 Prompt;替换更好的模型后,回答质量得到改善。
经验表达我们用“无需 Prompt,也能把 60 分抬到 70 分”形容变化。
第二件事:换模型后,旧 Prompt 未必还能用。
替换模型后沿用旧 Prompt,回答质量仍然不好。
做了什么删掉约 80% 的 Prompt 内容。
看到的变化回答质量出现明显改善。规则越多,并不一定回答越好。
一次有用的回答,
下一次还找得到吗?
我们设计了历史记录和收藏,希望让一次对话延伸为后续可再次使用的服务。
项目 Q&A
做下来,用户和业务发生了什么变化?
这次复盘里,我们同时看到了正向价值与商业代价。
搜索场景人均分发
搜索场景的提升幅度
自然语言 Query 占比
对照:传统搜索为 1%
人均对话轮次
对照:传统搜索为 0.x
正向变化
留存和总分发都有显著的微涨。自然语言提问与对话行为的变化,也被我们理解为用户心智的扭转。
同时出现的商业影响
AI 搜索与传统搜索争夺商业量,人均收入下降,但不显著。
当时怎么判断回答好不好?
前期:评测与内部体验
依赖评测团队打分、部门内测和负责人判断,在探索中建立标准。
上线初期:社区内测、访谈和定期评测
开展 1 万规模的小米社区内测,收集用户反馈、访谈用户,并定期评测回答质量。
正常实验期间:用户行为、转化与留存
持续观察用户 Query 类型、连续会话次数、转化率和留存,并结合评测判断回答质量。
用户实际都在搜什么?
半数以上的 Query 来自引导页豆腐块中的预设问题,其次是按类型找应用。用户也有发现小众、长尾应用的需要。
相比之下,搜索应用内服务的情况较少,直接输入准确应用名称的情况基本没有。
除了搜 App,AI 搜索还能往哪里延伸?
小米已经做过的延伸:搜索影视内容,并支持跳转观看,让用户从“找到内容”继续走到“开始观看”。
传音可以优先探索的方向:一是手机管理,围绕手机使用中的实际问题提供帮助;二是强化多语言能力,让用户能用熟悉的语言表达需求,也能看懂搜索结果。
整个项目真正难的地方,
是建立信任。
理解一句话只是起点,供给、内容、交互与业务都需要一起接住它。
用户最终会用三个问题,反复检验这次搜索。
- 01这个结果,真的适合我的场景吗?
- 02推荐理由可信吗,我能核验吗?
- 03比我自己搜,真的更省事吗?